边缘设备命令工作台在本地浏览器中提供一个专注的操作界面:用户输入简短请求,应用从允许的候选命令中给出排序结果。模型和 tokenizer 运行在 RK3576 上,请求可以留在本地网络内。
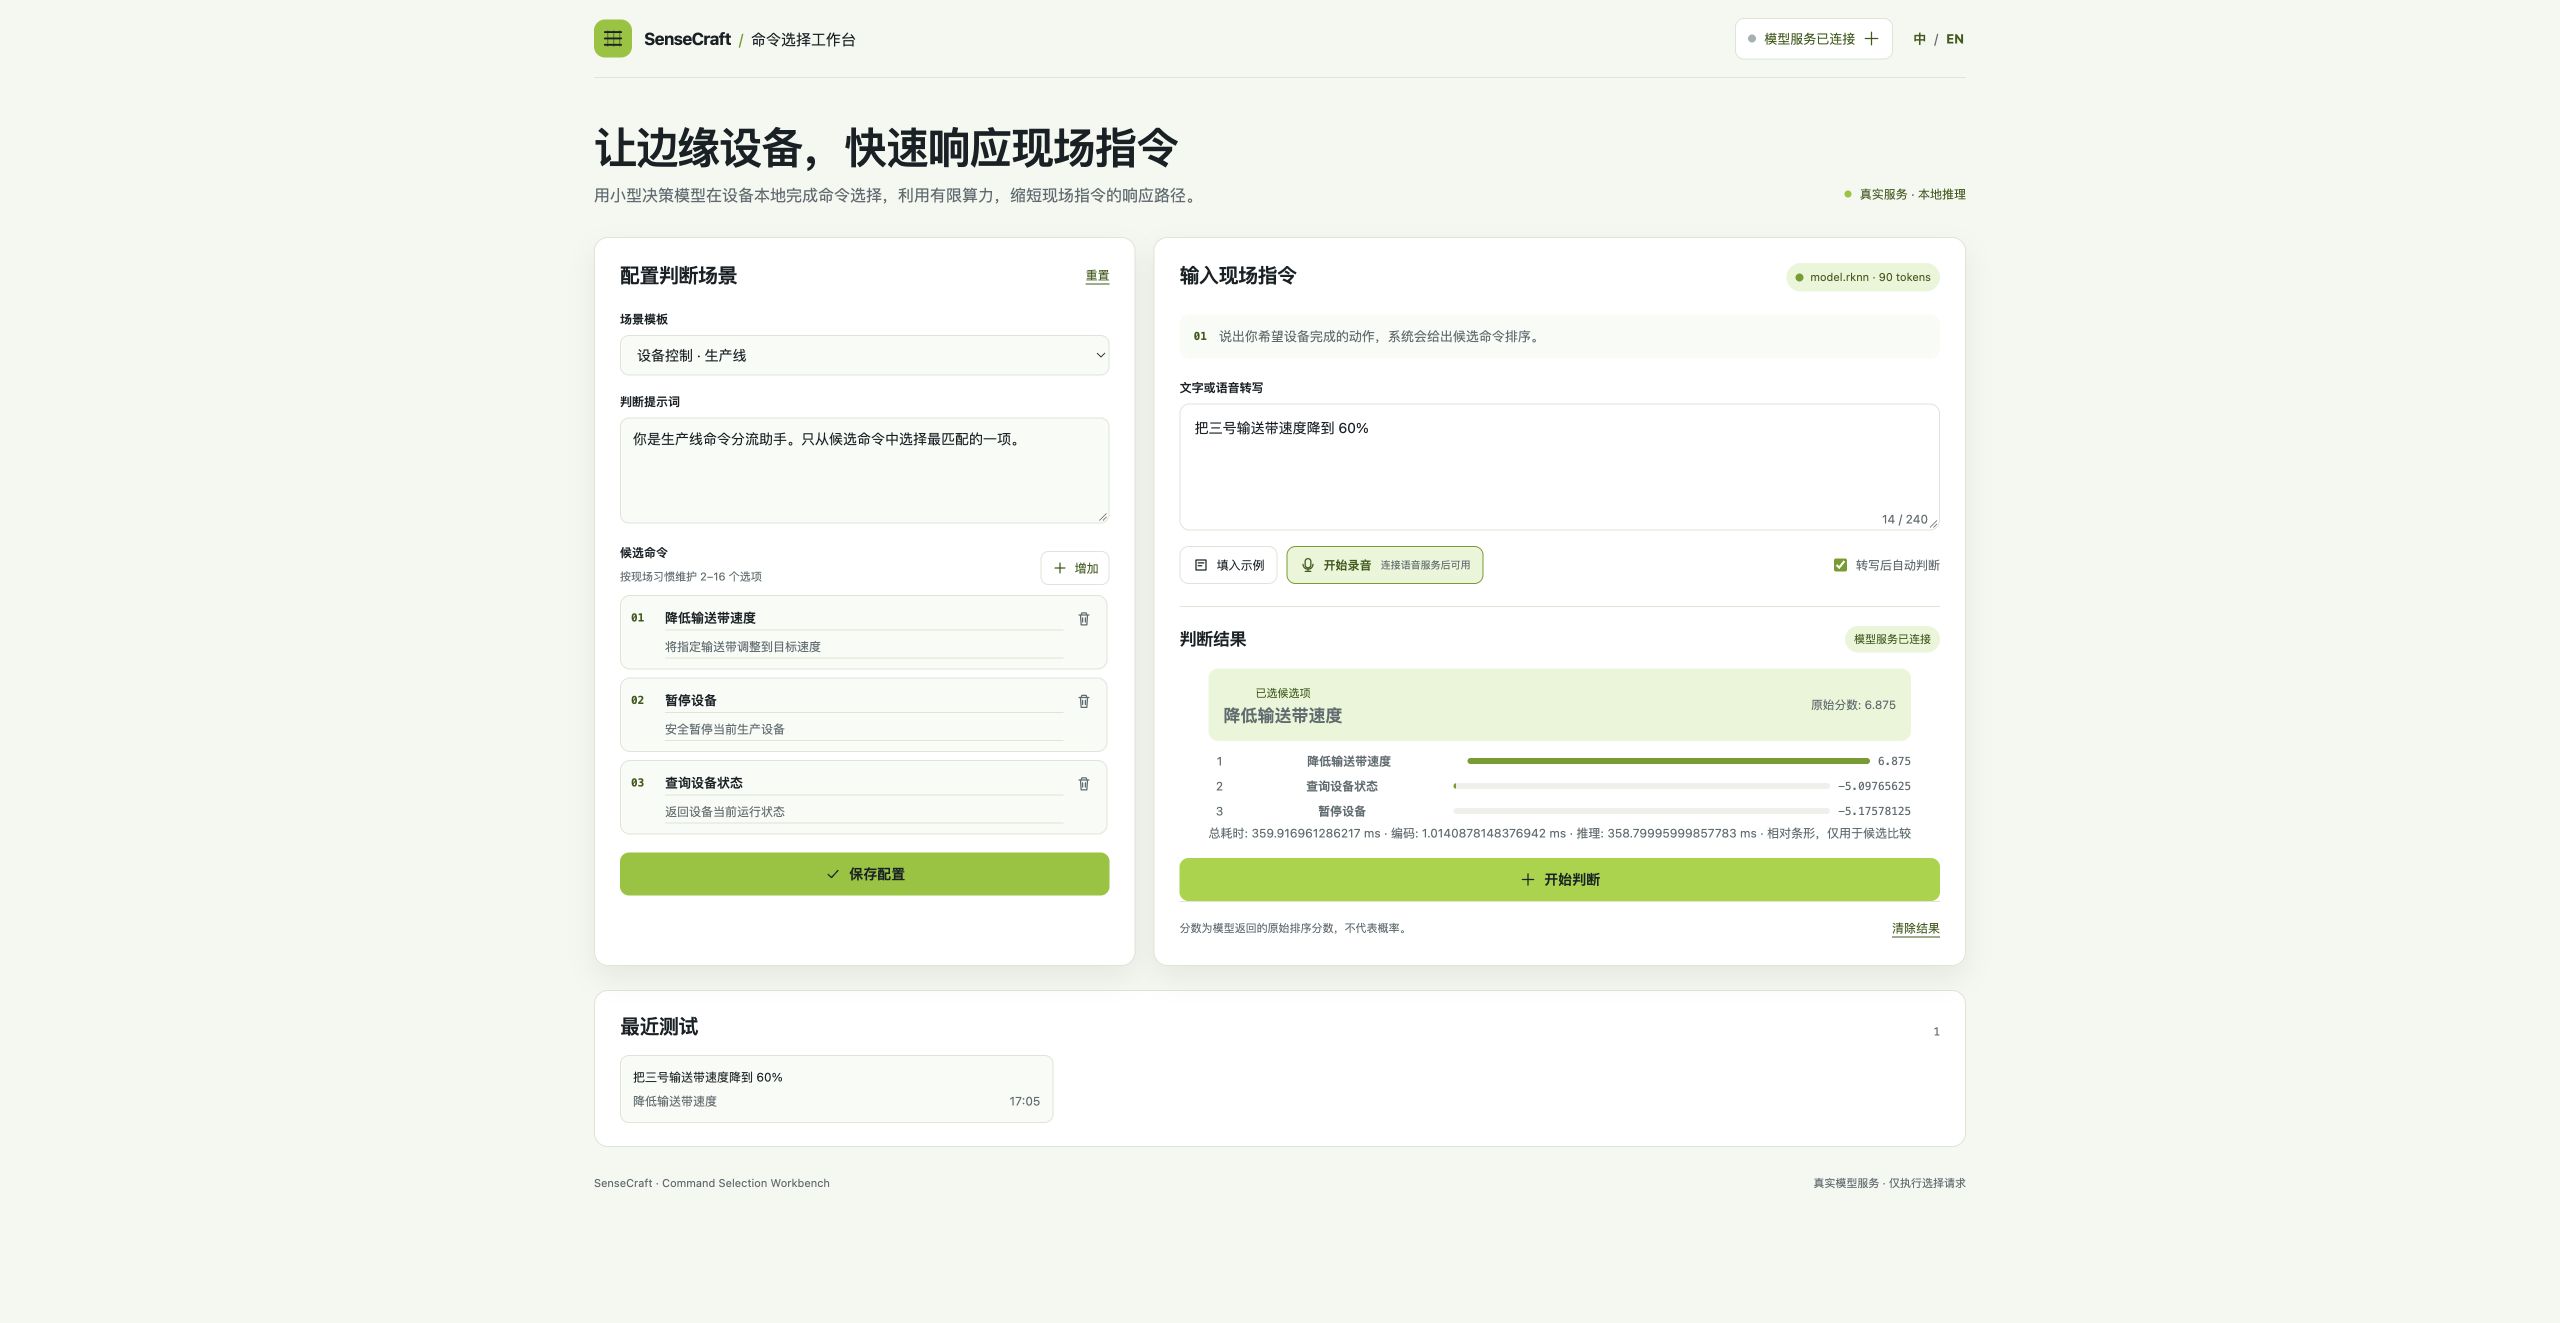
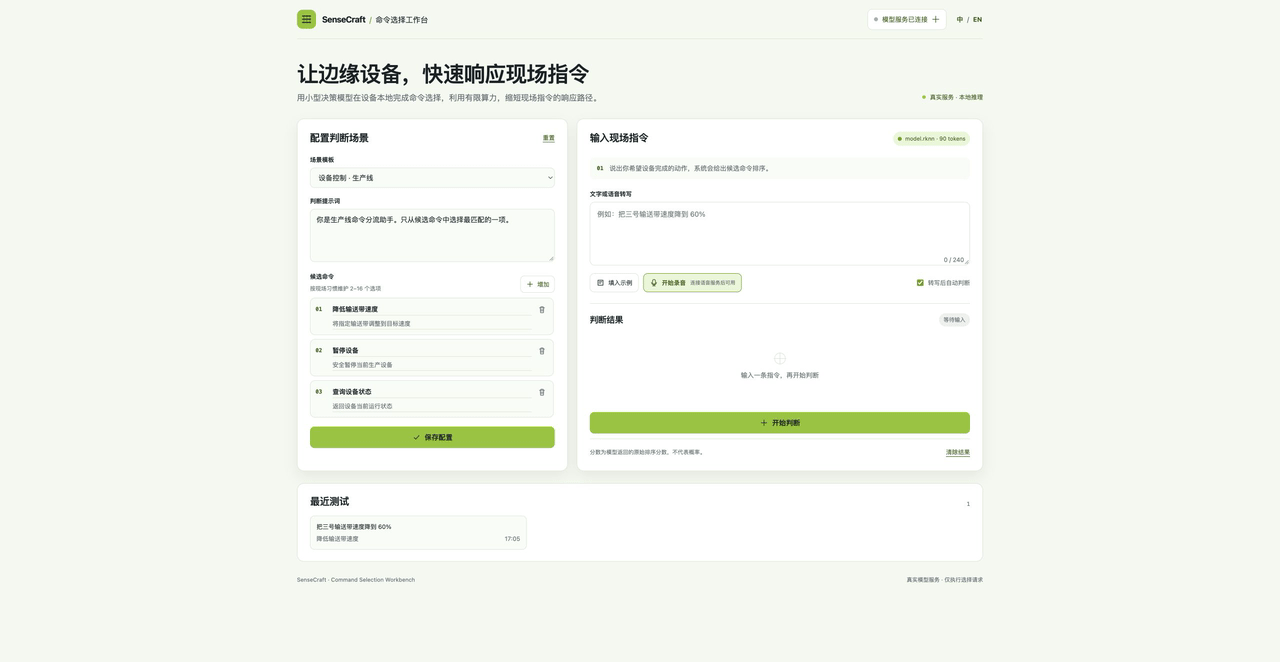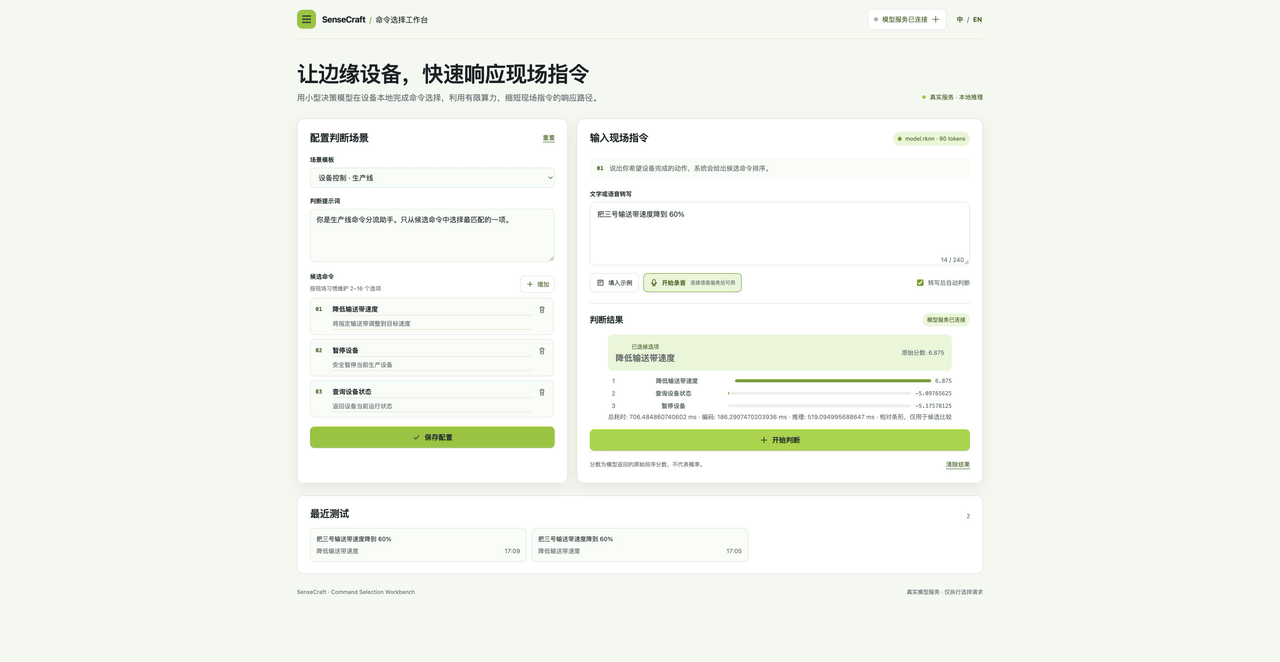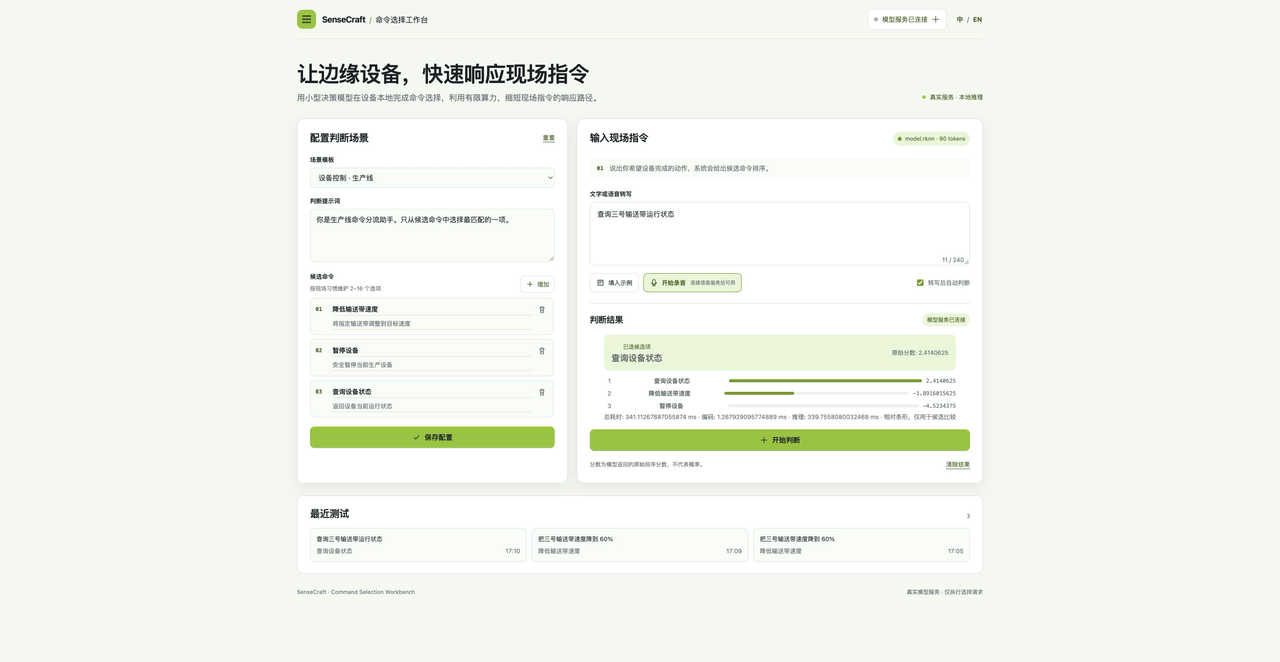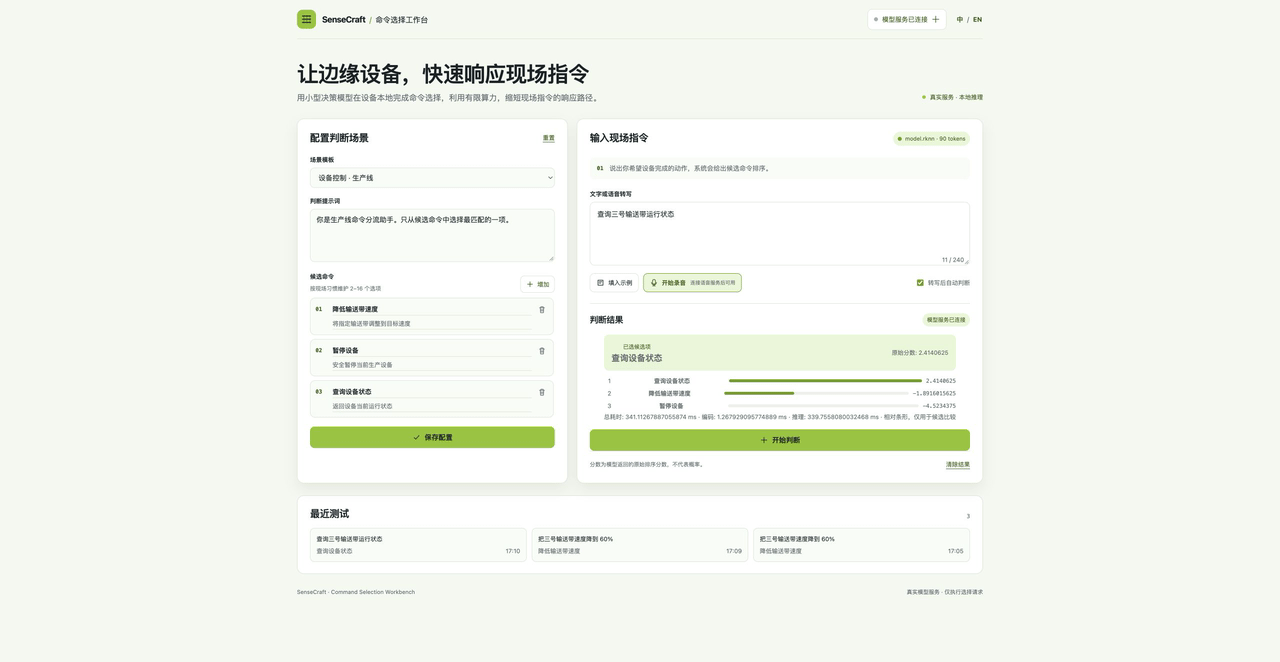
在 RK3576 和 RK3588 本地运行的设备命令工作台,把简短的机器请求转换为排序后的命令选择。
边缘设备命令工作台在本地浏览器中提供一个专注的操作界面:用户输入简短请求,应用从允许的候选命令中给出排序结果。模型和 tokenizer 运行在 RK3576 上,请求可以留在本地网络内。
| 好处 | 具体说明 |
|---|---|
| 保持请求本地处理 | 候选命令选择在 RK3576 上完成,不需要把请求发送到云端。 |
| 接入已有控制系统 | POST /api/decide 返回 JSON 选择结果和排序,可接入设备控制程序或网页应用。 |
| 限定可执行范围 | 由你的应用提供允许的候选命令,工作台只对这些选项排序,不生成不受控的任意命令。 |
| 保持边缘路径简洁 | 在已验证的 RK3576 环境中,对同一条 43-token 输入重复执行 120 次,total 延迟 p50 为 335.43 ms。这是延迟观察值,不是准确率结论。 |
| 按需连接语音 | 已有兼容的本地语音服务时可通过 VOICE_SERVICE_URL 连接;本方案不会自动安装语音服务。 |
| 场景 | 怎么用 |
|---|---|
| 输送带控制 | 提供“设置速度”“停止”“读取状态”等候选项,再为“把 3 号输送带降到 60%”排序。 |
| 工厂状态面板 | 让操作员用中文或英文短句选择“读取状态”动作。 |
| 机器人或网关接入 | 由已有控制系统发送候选列表,并读取 JSON 中的选中项。 |
| 设备 | 说明 | 必需 |
|---|---|---|
| RK3576 Linux 设备,例如 LubanCat3 | 运行单容器 Web 工作台和 RKNN 模型 | ✓ 必选 |
现有已验证包面向 RK3576/RKNN。历史 rk3576_remote 套餐使用独立的 Laya/RKNN 0.1.0 路径,与当前 Kev RKLLM 套餐保持分离。RKLLM Kev 已在 RK3576 测试平台 和 RK3588 测试平台 完成设备验证:RK3576 部署请求限制为 2048 tokens,engine 导出容量为 8192;RK3588 部署上下文为 8192。应用 Docker 源中保留现有 Jetson TensorRT 部署;本方案介绍页不宣称 Jetson 原生 Kev 支持。
/usr/lib/librknnrt.so。privileged 模式,通过 RK3576 NPU DRM 节点、只读设备树路径和只读 RKNN 运行库挂载访问运行时。https://hf-mirror.com。MODEL_SERVICES_JSON 可将另一模型系列指向已有 HTTP 服务,不会同时把两套模型加载到内存。只有提供已有兼容的本地语音服务时才可使用语音输入。本方案不会自动安装语音服务。浏览器麦克风访问需要 HTTPS 或 localhost。
gallery/kev-final/ 保存了 2026-10-11 RK3588 测试平台 候选版本的中英文页面截图、pending 状态和截图剪辑。素材 SHA、服务地址、健康响应和请求元数据见 gallery/kev-final/README.md 与 kev-final-evidence-20261011.json。截图剪辑展示文字决策流程。使用语音时连接已有兼容 ASR,并在 HTTPS 或 localhost 页面授权麦克风;协议验证证据见 assets/evidence/voice-proxy-contract-20261011/。
| 硬件/后端 | 当前状态 |
|---|---|
| RK3576 / RKNN Laya | 既有已验证路径 |
| RK3588 / RKLLM Kev | RK3588 测试平台 已验证 8192 context、5 条 golden、超长输入错误和双模型 HTTP 切换;RKLLM 0.3.1 ef82 已发布 |
| RK3576 / RKLLM Kev | RK3576 测试平台 500-token fixture:240 条中正确 189 条(78.75%);部署限制 2048 tokens,engine 容量 8192 |
| Jetson / TensorRT | 保留既有 TensorRT 路径;不宣称 Jetson 原生 Kev 支持 |
可复现的 context-500 fixture 保存在 assets/evidence/context500-20261011/。其中包含 120 条 original 和 120 条 reverse case,每条 assembled input 固定为 500 tokens。冻结 dataset、metadata、runner、逐请求 JSONL、summary、日志和监测记录按设备保存。
| 设备 | 正确数 | HTTP 错误 | client p50 / p95 |
|---|---|---|---|
| RK3576 测试平台 | 189/240(78.75%) | 0 | 7115.31 / 7574.56 ms |
| RK3588 测试平台 | 189/240(78.75%) | 0 | 3946.52 / 4770.96 ms |
该 fixture 使用生成的文档上下文将输入固定为 500 tokens。测量对象是这批固定生成背景与候选项;实际业务命令的指标需用对应标注测试集另行测量。工作台输出候选项 ID 供调用系统处理。source、generator、dataset SHA、runner SHA 和设备绑定均记录在证据目录中。
双模型切换的真实浏览器素材位于 gallery/kev-final-switch/:Laya 页面 chip/result 均显示 rknn / 90 tokens,Kev 页面 chip/result 均显示 rkllm / 8192 tokens。同一条英文指令分别通过下拉选择两个 profile;Test and connect 的真实 GET /api/models 返回 HTTP 200。素材说明了最终 UI 的可读性取整(score 三位小数、毫秒一位小数),raw API 数值保存在 evidence JSON 中。
核对方案与产品清单,再照部署指南装。
部署已测试的 RK3576 Kev RKLLM 配置,请求上限为 2048 tokens;engine 导出容量仍为 8192。
2 步
本地命令工作台的健康状态。
为用户请求排列候选机器命令。
{"prompt":"Choose the best machine command.","input_text":"Read current conveyor status.","options":[{"id":"status","label":"Read status"},{"id":"stop","label":"Stop"}]}首次下载固定版本产物需要网络;目标设备已有产物时可离线启动。
Kev 首次准备至少保留 3GB 可用空间;实测新鲜产物峰值约 1.94GB,并保留 1GB 余量。既有 RKNN 路径另行要求 4GB。