可复用现场模板
人站着出声说话、手上腾不开、答错了要能马上打断的地方。
服务台与展台
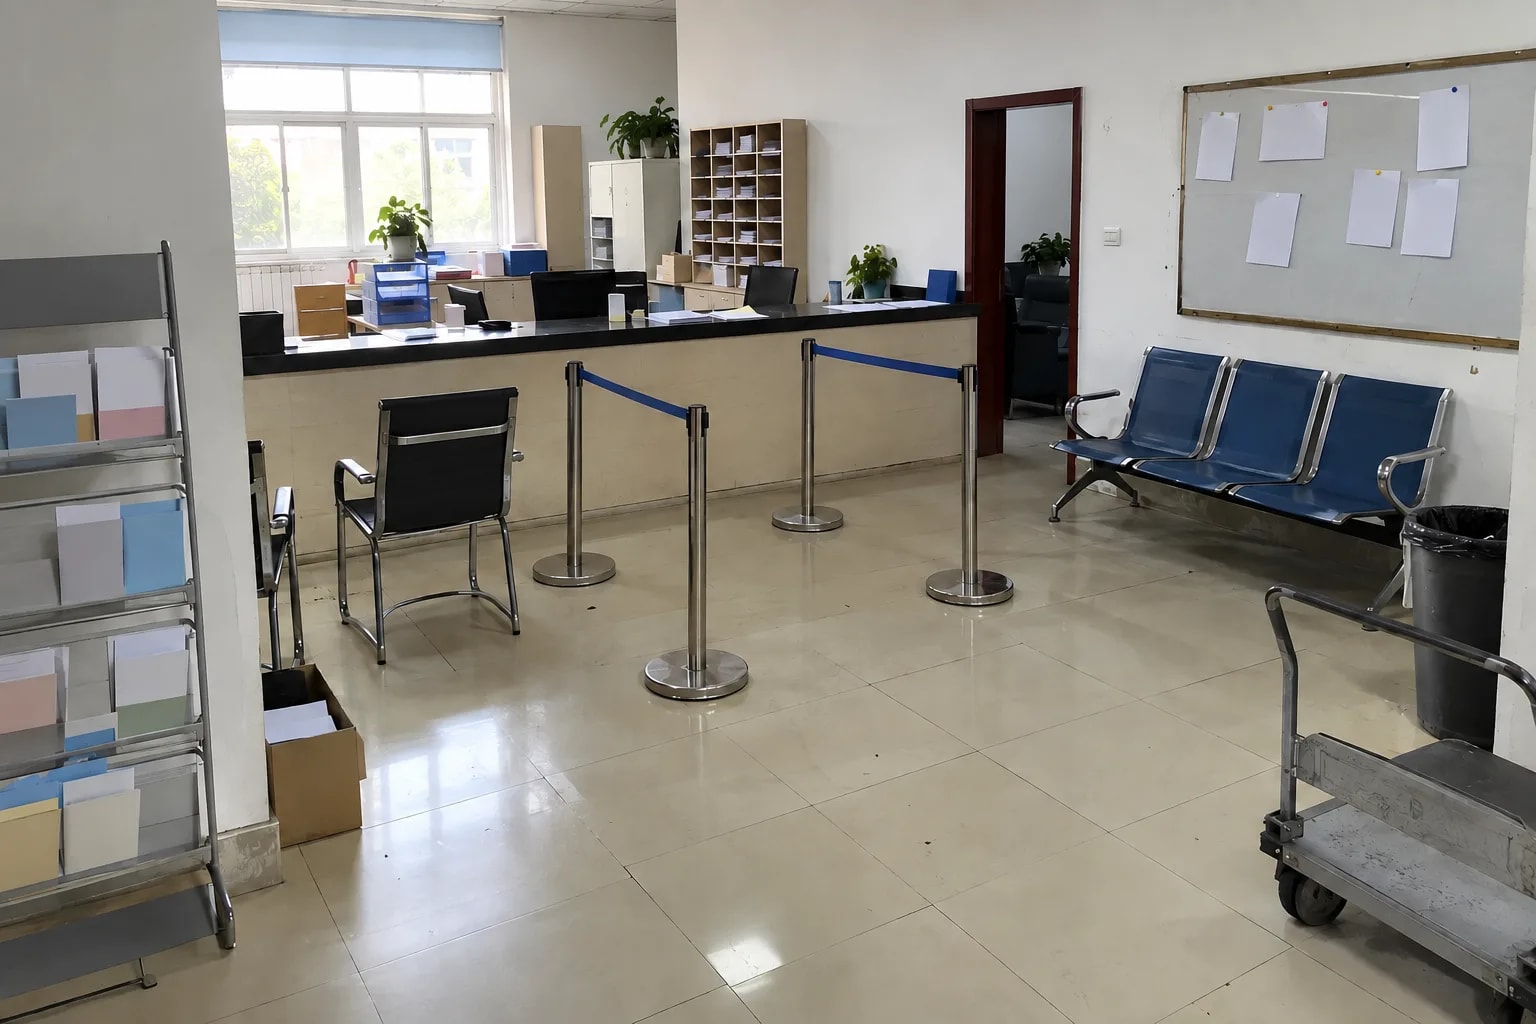
政务大厅咨询台、展会展位、门店导购台。答非所问时打断重问。
机器人与设备语音入口
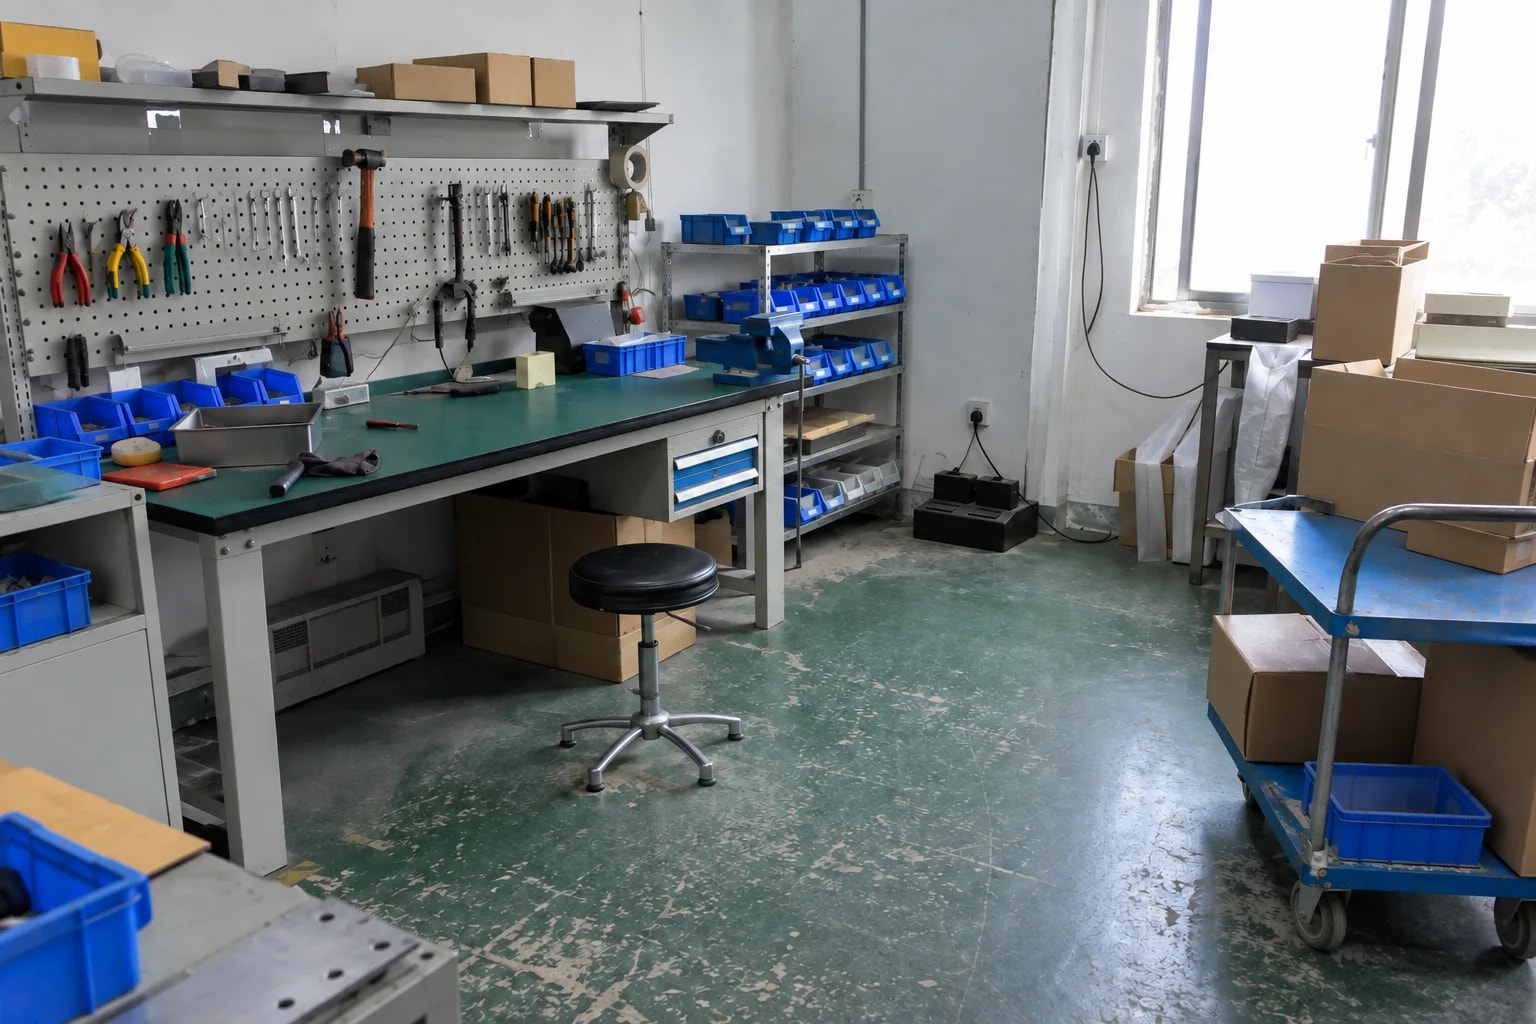
桌面机器人、配送机器人、车间操作台。后面换什么模型,前面这一层不变。

房间与家居终端
客厅、会议室、酒店客房。远场说话可用,播放回复时不会自己触发。
不适用:没有硬件回声消除的麦克风。reComputer R2000 系列上的中文。
如何实现
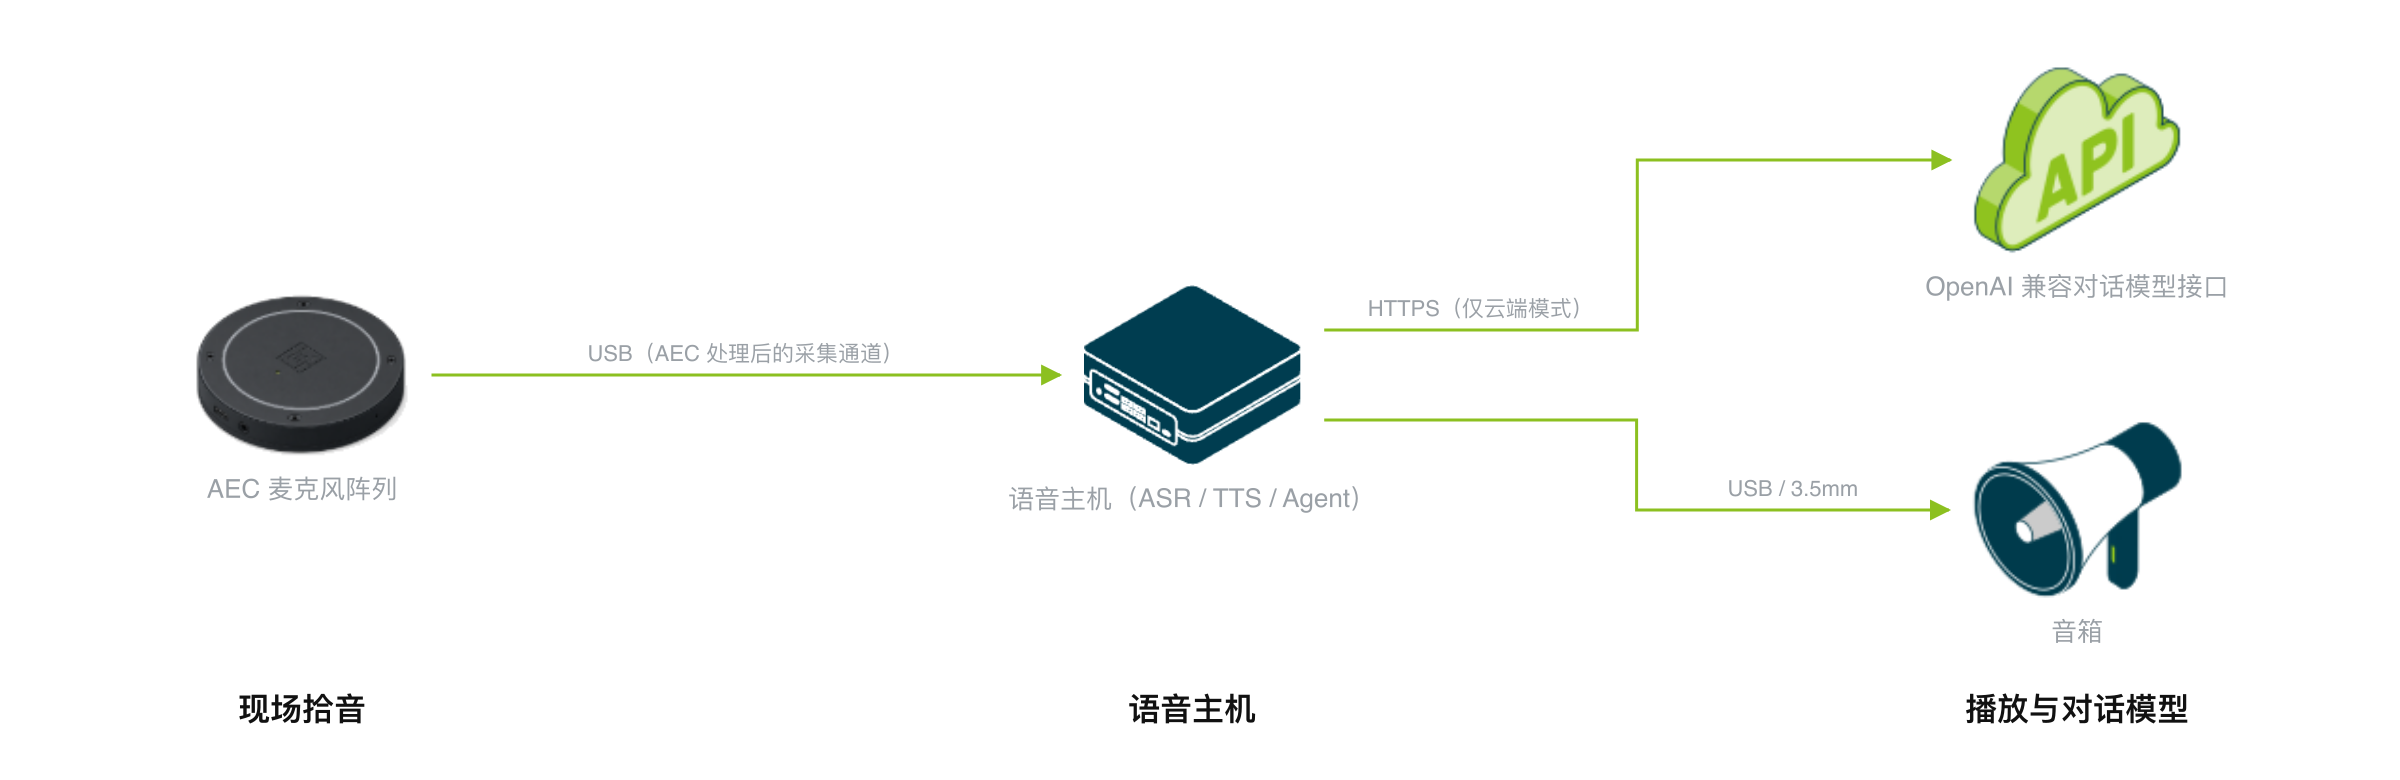
麦克风阵列采集语音,边缘语音主机完成识别与合成,音箱播放回复。对话模型运行在该主机,或接入自有接口。
四样东西:一只已经把回声消掉的麦克风阵列、一个音箱、一块跑识别 / 合成 / 常驻 Agent 的边缘算力板,以及一个对话模型——它要么在接口后面,要么就在同一块板上。前三样永远在现场;这条链路要不要过外网,只由第四样决定。
现场拾音
麦克风是硬要求。 它必须输出一路硬件上已消掉回声的采集通道;普通 USB 麦克风会把音箱的声音重新采进来,终端开始自己打断自己。
- reSpeaker XVF3800 是已验证的默认选择——USB 接口,硬件回声消除、降噪与波束成形,自动选中已处理的那一路。
- 其他阵列默认取第 1 个采集通道,上线前需要在现场做一次声学实测。
- USB 或 3.5mm 音箱播放回复。播放期间静音麦克风能躲开回声,但打断也一起没了。
麦克风可以在 Agent 运行中拔插,采集不重启容器即可恢复。
语音主机
一块板跑识别、合成和常驻 Agent,它同时决定你能提供哪些语言。
| 语音主机 | 中文 | 英文 | 其余 28 种语言 | 本地对话模型 |
|---|---|---|---|---|
| reComputer RK3576 | Qwen3-ASR W8A8 + Matcha | Qwen3-ASR W8A8 + Matcha | 不支持——该板 TTS 只有 Matcha zh-en | 无 |
| reComputer RK3588 | Qwen3-ASR W8A8 + Matcha | Qwen3-ASR W8A8 + Matcha | Qwen3-ASR + Kokoro RKNN | 需加 RK1828 / RM182X 卡 |
| Jetson Orin Nano 8GB | Qwen3-ASR int4 + Matcha | Qwen3-ASR int4 + Matcha | Qwen3-ASR + Qwen3-TTS | 无——不要在 Nano 上起 4B 模型 |
| Jetson Orin NX 16GB | Qwen3-ASR int4 + Matcha | Qwen3-ASR int4 + Matcha | Qwen3-ASR + Qwen3-TTS CustomVoice | Qwen3.5-4B 与语音同机 |
| reComputer R2000 系列 | 拒绝 | sherpa-onnx CPU | 不支持 | 无 |
板子服务不了的语言,部署直接停住。 reComputer R2000 系列上选中文会被拒绝,而不是交给一个中文 CER 在 35–56% 的模型。矩阵共 18 格,5 格实测、10 格可部署但没有量化数据、3 格拒绝,完整列表见工程 Wiki。
播放与对话模型
整条链路里,只有这一个选择决定数据要不要出场地。
| 路线 | 谁在跑 | 前置条件 |
|---|---|---|
| 云端或 OpenAI 兼容接口 | 默认 Qwen API,也可填你自己的接口、Key 与模型 | 持续联网、有效 Key、支持流式 Chat Completions |
| 设备本地,RK 路线 | RK3588 主机上挂 RK1828 / RM182X 卡跑 Qwen3-4B | 卡需独立 12V 供电与驱动;一张卡只常驻一个大模型 |
| 设备本地,Jetson 路线 | Orin NX 16GB 上跑 Qwen3.5-4B,与语音同机 | JetPack 6.2、至少 25 GB 空闲磁盘、没有别的 GPU 容器 |
三条路线对外都是同一套 OpenAI 兼容接口,切换时只改模型地址。首次联网启动把镜像和模型缓存完成后,本地路线可以断网运行。数据接口见下方「能拿到什么数据」。
实现什么效果
装好之后,你在浏览器面板上看到的整场对话。
实测数据
语音链路在两块板上实测,除注明外链路里没有接对话模型。
| 用户能听到什么 | 典型值 | 设备 | 含对话模型 |
|---|---|---|---|
| 说完话到第一帧语音回复 | 800 ms 以内 | reComputer J40 系列 | 是 |
| 说完话到第一帧语音回复 | 100 ms p50 | reComputer J40 系列 | 否 |
| 说完话到第一帧语音回复 | 约 1.6 s | reComputer RK3576 | 否 |
| 说完话到出文字结果 | 16 ms p50 | reComputer J40 系列 | 否 |
| 中文短句识别错误率 | CER 1.05% | reComputer RK3576 | — |
| 英文短句识别错误率 | WER 3.65% | reComputer RK3576 | — |
不含对话模型的几行,实际部署还要加上所选模型的响应时间;换用云端接口时取决于网络往返。10–20 秒的长句上,识别错误率升到中文 CER 9.62% / 英文 WER 6.99%。
会话在第一个自然停顿处就回复。 轮次检测在 2.5 秒最小音频之后再等 400 毫秒静音,所以中间带停顿的长句只会得到第一个分句的回复。各设备端到端语音识别与合成时延矩阵,详见 工程 Wiki · 对话式语音 AI 方案。
能拿到什么数据
所有接口都由语音主机自己提供;除非把对话模型指向外部,数据不经过任何云端组件。
| 接口 | 跑在哪 | 承载什么 |
|---|---|---|
ws://<host>:8621/v2v/stream | 语音服务,所有套餐 | 双工会话:送 PCM 进去,拿转写和合成音频出来,打断触发的中止也走这里 |
POST http://<host>:8621/asr | 语音服务 | 离线整段转写;上面的精度数字就是在这个接口上测的 |
POST http://<host>:8621/tts | 语音服务 | 合成,响应头带实时率 |
http://<host>:18000 | Agent | Web 面板——listening / thinking / speaking / barged-in 状态,以及每轮的转写 |
http://<host>:1828/v1 | RK1828 卡,RK 本地套餐 | 设备上 Qwen3-4B 的 OpenAI 兼容 Chat Completions |
http://<host>:8000/v1 | Orin NX,Jetson 本地套餐 | 设备上 Qwen3.5-4B 的 OpenAI 兼容 Chat Completions |
| 对话模型地址(出向) | 云端套餐 | 任意 OpenAI 兼容接口,默认 Qwen API |
对接点是对话模型接口,不是消息主题。 把模型地址指向你自己的服务——Agent 框架、RAG 接口、机器人指令层——语音层不用改。
移植到你的业务系统
可复用的单元是「硬件回声消除采集 → 本地识别 → 一次 OpenAI 兼容调用 → 本地合成 → 可打断的播放」这条链路。链路上只有一环跟产品做什么绑定,而那一环在一个 URL 后面。
| 层 | 移植时你要做的 |
|---|---|
| 麦克风选择、通道识别、热插恢复 | 直接复用 |
| 四套加速器运行时上的 Qwen3-ASR 与 Matcha-TTS | 直接复用 |
| 双工会话、打断、播放队列排空 | 直接复用 |
| 语言与板卡组合检查,不支持即拒绝 | 直接复用 |
| 对话模型地址后面的那个服务 | 你的产品就长在这里 |
| 系统提示词与回复长度策略 | 按新任务调 |
任何支持流式 Chat Completions 的东西都能直接顶上:查自有文档的 RAG 服务、带工具调用的 Agent 框架、机器人指令层、工单或点单后台。
不适用的形态
- 只需要唤醒词的单命令设备。 按一下说一句的产品用不上持续监听和打断机制,只多出成本。
- 需要给出时延承诺的部署。 上面每行的数字只对那一行写明的板子和前提成立;换设备或换模型后请在自己的配置上实测。
- 30 语种表之外的语言,以及 reComputer R2000 系列上的中文。 两者都在部署时直接拒绝。
如何部署
说说你的现场情况,硬件由我们来定;再接上数据、照步骤装。
交互语言
现场的人会用哪种语言跟它说话?板子既要听得懂,也要说得出这门语言。不是每块板都做得到。
或者自己比一遍:各配置参数对照部署指南 · 30min →
| 套餐 | 用途 | 设备 | 数量 |
|---|---|---|---|
| 云端或 OpenAI 兼容模型 | 运行设备 | reComputer RK3576 系列 / reComputer RK3588 系列 / reComputer J30 系列(Jetson Orin Nano) / reComputer J40 系列(Jetson Orin NX) / external_raspberry_pi_5(二选一) | 1 |
| AEC 麦克风 | reSpeaker XVF3800 四麦阵列 | 1 | |
| 全本地对话 | 本地 AI 设备 | reComputer RK3588 系列 / reComputer J40 系列(Jetson Orin NX)(二选一) | 1 |
| AEC 麦克风 | reSpeaker XVF3800 四麦阵列 | 1 |
| 套餐 | 对话模型 | 支持的语音主机 | 能否断网 | 适合谁 |
|---|---|---|---|---|
| 云端或 OpenAI 兼容模型 | 默认 Qwen API,也可填任意接口 / Key / 模型 | RK3576 · RK3588 · Orin Nano 8GB · Orin NX 16GB · reComputer R2000 系列 | 不能——模型调用需要网络 | 最快跑通完整对话;已经在付费的模型直接接进来 |
| 全本地对话 | RK1828 / RM182X 上的 Qwen3-4B,或 Orin NX 16GB 上的 Qwen3.5-4B | RK3588 + RK1828 · Orin NX 16GB | 能,镜像与模型产物缓存完成之后 | 对话文本不能出场地、需要固定运营成本 |
两个套餐的语音都在本地,套餐决定的只是对话模型跑在哪。云端套餐沿用上游 推荐 角标。
难度定级 intermediate,约 30 分钟;全本地套餐首次启动要下载模型产物,耗时更久。
常见问题
能。播放期间采集不关闭,回复中途说话就会中止生成、清空播放队列并开启下一轮。验收是部署指南里的人工测试——连续三轮,每次在回答开始后 0.5–1 秒打断。
麦克风必须带硬件回声消除通道;普通 USB 麦克风会把音箱的声音采回来,终端会自己打断自己。reSpeaker XVF3800 是已验证的默认选择。其他阵列走第 1 个采集通道,上线前需要现场声学实测。
所有套餐的语音都在本地,其余取决于对话模型。云端套餐需要持续访问 API。全本地套餐在首次联网启动把镜像和模型缓存完成后可以断网运行。
语言表共 30 种。中文和英文在 RK3576、RK3588、Orin Nano、Orin NX 上可用,英文在 reComputer R2000 系列上也可用;其余 28 种语言需要 RK3588 或 Jetson。reComputer R2000 系列上的中文会被拒绝。
Whisper 在已实测的每块板上中文 CER 都在 35–56%,以这种错误率运行的部署看起来能用,实际不能用。语言与板卡组合在任何服务启动前检查,问题在部署时就暴露。
reComputer RK3576 上,中文短句 CER 1.05%、10–20 秒长句 9.62%;英文短句 WER 3.65%、长句 6.99%。reComputer J40(Orin NX 16GB)上的 Qwen3-ASR 在 2026 年 7 月实测 golden set CER 0。18 格语言 × 板卡组合里,10 格可部署但没有量化数据。
实时会话在听到第一个停顿时就结束这一轮,中间带停顿的长句只得到第一个分句的回复,按完整参考文本算是中文 CER 84.06%。这是轮次设计,不是识别错误。把轮次检测调到能挺过句中停顿是待办事项。
把对话模型地址指向你自己的服务。任何支持流式 OpenAI 兼容 Chat Completions 的东西——RAG 服务、Agent 框架、机器人指令层——都能直接顶上,语音层不用改。
没有找到你要的答案?
联系我们
获取可部署方案与产品选型支持。