零售语音
门店里的对话自动转成文字存下来。
门店、会议、咨询对话转成文字,进入零售语音后台;可用麦克风阵列接本地转写主机,也可佩戴 reSpeaker Clip 配手机。姓名号码入库前替换,可按请求删除。
中级60min音频与声音智能
可复用现场模板
说话人在麦克风 3 米内、对话要留成文字的地方。

连锁门店服务核查
便利店收银台、手机店与药店柜台。店员与顾客的对话按门店存成文字。
会议与培训
会议室、培训教室。桌上放一台阵列,发言转成文字存档。

咨询与问诊
诊室、保险与理财咨询间。一对一对话留文字,删除请求把记录和音频一起删掉。
不适用:拾音距离超过约 3 米的房间、用说话人标签做身份核验,以及需要合规认证的场合。稳态背景噪声高于 70 分贝时,识别错误率高于实测数字。
如何实现
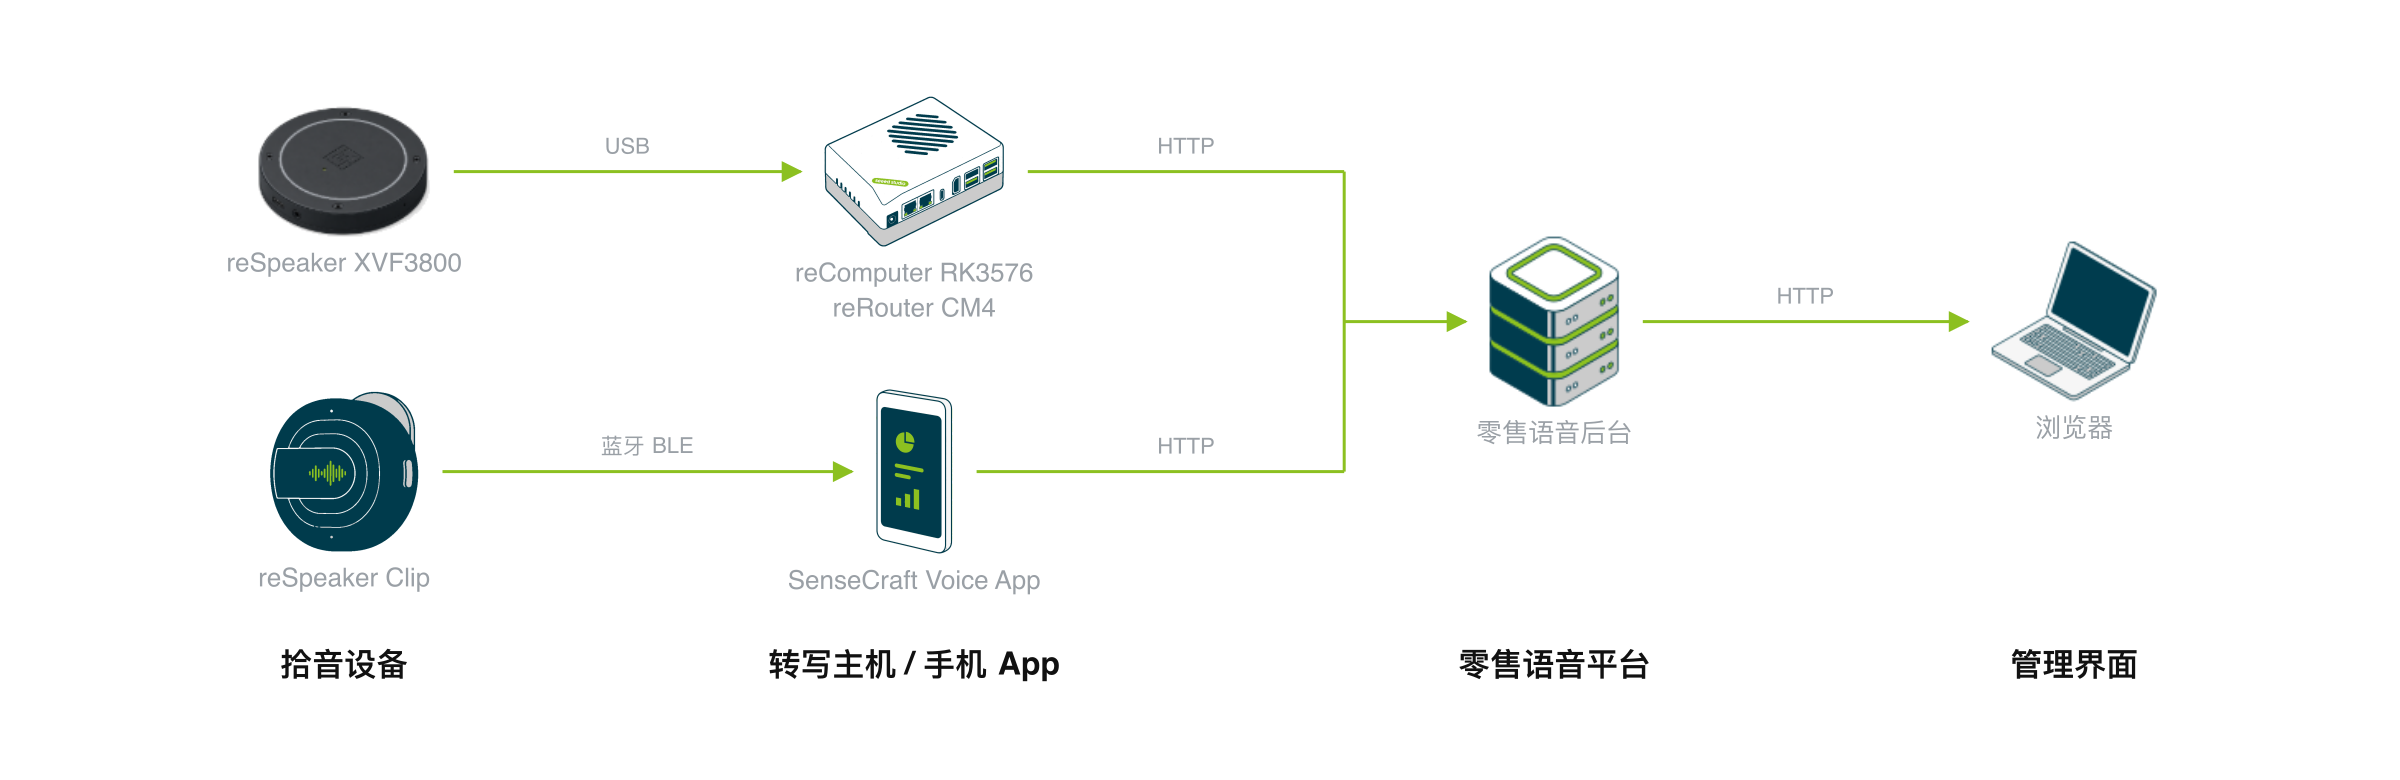
reSpeaker XVF3800 麦克风阵列接转写主机(reComputer RK3576 或 reRouter CM4),或由 reSpeaker Clip 经手机 App 采集。两条路线均写入同一零售语音后台。
音频有两种采集方式:麦克风阵列,或 Clip 加手机。主机本地识别后传文字,手机则把音频传到服务端识别。两条路径进同一个零售语音后台,在管理界面查看。
拾音设备
USB 主机口上接一只 reSpeaker XVF3800。回声消除、波束成形和噪声抑制在阵列自带的 DSP 上完成,盒子拿到一路 16 kHz 单声道音频,不占主机 CPU。
- 稳态背景噪声不高于 70 dB——超过后阵列分不开说话人和环境,识别错误会上升。
- 说话人距阵列约 3 m 以内——超出后转写质量下降,与盒子型号无关。
- 一只阵列覆盖一个说话区——第二个柜台需要第二只阵列和第二台盒子。
另一条路径上,由 reSpeaker Clip 代替阵列录音。
转写主机 / 手机 App
端点检测、语音识别、标点恢复和可选的声纹向量都在这台盒子上完成。
| 主机 | ASR 跑在哪 | 模型 | 全部加载时的内存 | 实测覆盖 |
|---|---|---|---|---|
| reRouter CM4 | 4 个 Cortex-A72 CPU 核 | Paraformer 流式 | 现场试点 | 仅声纹向量(A72 同档) |
| reComputer RK3576 | 6 TOPS NPU | SenseVoice RKNN fp16 | 1.71 GiB | ASR、流式时延、内存、重启 |
标点和声纹各自加载一个模型,部署时可以分别关闭。
Clip 路径上,手机里的 SenseCraft Voice App 经蓝牙 BLE 连 Clip 并上传音频,不需要转写主机。
零售语音平台
两条路径写入同一个零售后台,区别在识别跑在哪。
- 设备本地转写——主机本地转写,只上传文字;上行中断时,网络恢复后再上传。
- Clip 加手机——后台识别上传的音频,再脱敏、存储文字。
后台主机还承载数据库、对象存储和浏览器里打开的管理界面,需要 20 GB 可用空间;镜像只有 arm64 版本。数据接口见下方「能拿到什么数据」。
实现什么效果
装好之后,门店在浏览器后台里看到的录音和能做的事。
实测数据
只测识别本身,设备为 reComputer RK3576——时延行不含上传、脱敏与入库。
| 门店能得到什么 | 典型值 | 设备 |
|---|---|---|
| 说完话到出最终文字,12 路并发 | p95 1067 ms(p50 583 ms) | reComputer RK3576 |
| 中文识别错误率(AISHELL-1 100 句) | CER 4.82% | reComputer RK3576 |
| 删除某个人的记录后留下的数据 | 数据库、对象存储与本地音频三处均为 0 | 服务端栈套餐 |
| 个人信息被脱敏识别出来的比例 | precision 0.98 / recall 0.95 | 服务端栈套餐 |
稳态背景噪声需不高于 70 dB,说话人距阵列 3 m 以内;超出任一条,识别错误率会高于表中数字。
盒子上的转写目录没有轮转,长期运行前先定好保留期。服务端栈上的原音频默认保留 24 小时(部署时可选 6 或 1 小时),不做脱敏。
各主机路数与测试条件详见工程 Wiki · 门店语音质检方案(文档合并发布后生效)。
能拿到什么数据
部署完成后,门店系统就靠这几个接口接数据。
| 接口 | 内容 | 路径 |
|---|---|---|
转写文件 <输出目录>/cache/asr/<id>.json | 每句一个 JSON:文本、时间戳、语种,开启声纹时带说话人标签 | 设备本地转写 |
流式 ASR ws://<设备IP>:8621/asr/stream | 送入 PCM,返回转写、标点和 192 维声纹向量 | 设备本地转写 |
离线 ASR POST http://<设备IP>:8621/asr | 整段文件转写 | 设备本地转写 |
本地网页 http://<设备IP>:8090/ | 实时转写、麦克风状态、声纹注册库,仅门店局域网可访问 | 设备本地转写 |
音频上传 POST :18621/v1/audio/transcriptions | SenseCraft Voice App 上传音频,平台转写、存储并展示 | Clip / 服务端栈 |
录音记录 :8081/api/v1/recordings | operator 上报、viewer 查询;文本在入库前完成脱敏 | 服务端栈 |
删除与导出 :8081/api/v1/privacy/erase、/export | 仅 admin:硬删除音频、文本记录与声纹;导出脱敏文本与音频清单 | 服务端栈 |
管理后台 :3000 | 录音、关键词、设备、导出与删除 | 服务端栈 |
入库的文本里,姓名与号码被替换成 [[NAME]] 这类占位符,原文不写入任何地方。说话人标签只在开启声纹匹配时出现,它是注册库里的标签,不是身份结论。
移植到你的业务系统
可复用的单元是「采集 → 识别 → 入库前脱敏 → 可删除的记录」这条链路。换一个现场,只有和语言绑定的部分要改:识别模型、声纹注册库、脱敏规则。
| 层 | 迁移代价 |
|---|---|
| 阵列机位规范(≤3 m、≤70 dB) | 原样沿用 |
| 采集客户端、端点检测、两套运行时 | 原样沿用 |
| 输出契约与访问角色(viewer / operator / admin) | 原样沿用 |
| 入库前脱敏,以及删除顺序(音频 → 记录 → 声纹) | 原样沿用 |
| 识别模型与语种 | 按目标语种或领域更换 |
| 声纹注册库、匹配阈值、脱敏词表 | 按语言与法域重新调整 |
| precision / recall 所依据的金标准集 | 自己采 |
同形态的用法:前台与柜台记录、咨询笔记、控制室内部留存的语音、本地部署的呼叫质检、外勤语音记录。
不适用的形态
- 身份核验。 说话人标签是按本地注册库做的聚类结果,不能用来控制门禁或支付。
- 远场或嘈杂的房间。 超过约 3 m 或稳态噪声高于约 70 dB,瓶颈在前端,换算力板补不回来。
- 需要证明说过的话已经没了。 只有文本做了脱敏,原音频在保留期内完整;以数字词念出的号码只覆盖 11 位中文手机号。
如何部署
说说你的现场情况,硬件由我们来定;再接上数据、照步骤装。
文字去向
文字最后要落到哪?这是分开两个套餐的那个决定。
或者自己比一遍:各配置参数对照部署指南 · 60min →
| 套餐 | 用途 | 设备 | 数量 |
|---|---|---|---|
| 设备转写并上传 | 边缘设备 | reComputer RK3576 系列 / reComputer RK3588 系列 / reComputer J30 系列(Jetson Orin Nano) / reComputer J40 系列(Jetson Orin NX) / reComputer Industrial R20 系列 / reRouter CM4 系列(二选一) | 1 |
| 麦克风阵列 | reSpeaker XVF3800 四麦阵列 | 1 | |
| Clip+手机,后台转写 | 栈主机 | reComputer RK3576 系列 / reComputer RK3588 系列 / reComputer J30 系列(Jetson Orin Nano) / reComputer J40 系列(Jetson Orin NX) / reComputer Industrial R20 系列 / generic_linux_host(二选一) | 1 |
| 采集来源 | reSpeaker Clip / external_mobile_app(二选一) | 1 | |
| 麦克风阵列 | reSpeaker Clip | 1 |
| 套餐 | 音频从哪来 | 转写落到哪 | 板卡 | 真机实测覆盖 |
|---|---|---|---|---|
| 设备本地转写 | 盒子上的 reSpeaker XVF3800 | 转写好的文本 JSON 上传到零售后台;可选 WAV 留在盒子上 | reRouter CM4(CPU)或 reComputer RK3576(NPU) | RK3576:时延、内存、重启。CM4:仅声纹向量 |
| 服务端栈 | 边缘采集端上的同一只阵列,或者手机 App(SenseCraft Voice App 配 reSpeaker Clip) | 数据库(入库前已脱敏);原音频按保留期存放;管理后台带删除与导出 | reComputer RK3576,或其他 arm64 Linux 主机 | 删除残留、脱敏 precision / recall、鉴权——在集成测试里,不是门店 |
两个套餐都标 Beta(测试版),难度 intermediate。设备本地转写在模型下载完成后约 40 分钟;服务端栈约 60 分钟,大部分时间在拉镜像。
两个套餐最后一步都是人工验收:有人说一句话,再读出来的文字。
常见问题
两者都写入零售后台,区别在识别跑在哪。设备本地转写在盒子上识别、上传转写好的文字;Clip 路径由手机上传音频,在服务端识别、脱敏和入库。
镜像和模型就位后,盒子上的识别可以继续跑,但转写好的文字要进零售后台才能存储和展示。Clip 路径还需要手机的上传通路。模型在首次启动时从部署时选定的镜像源下载。
设备本地转写只上传文字;WAV 片段留在盒子上,且只在开启文件输出时写入。服务端栈上,原音频放在栈主机上,默认保留 24 小时。另有一个默认关闭的 cloud-analytics 配置,打开后会把脱敏文本发出这台主机。
reComputer RK3576 上 12 路并发时,说完话到最终文字 p50 583 ms / p95 1067 ms,中文 CER 4.82%。这些数字只算识别,不含上传、脱敏和入库。真机测试是用文件送入音频,阵列的波束成形和回声消除不在这次测试范围内。
服务端栈上,admin 按人员、设备或会话发一次删除请求,依次删掉存储的音频、文本记录和声纹,只留一条不含原值的记录。随包集成测试里三处残留均为 0。设备本地转写没有删除接口,转写目录由你自己清理。
在 114 条中英文金标准集上,precision 0.98、recall 0.95,测在书面文本上。识别错误可能挪动实体边界,低置信度的实体进复核队列而不是被遮蔽。这是可复现的测试,不是合规认证。
不可以。标签来自按固定阈值与本地注册库做的声音匹配,适合区分对话轮次,不是身份核验。服务端栈默认部署里说话人匹配也是关闭的。
一是模型和组件的授权,各自遵循上游许可;服务端栈上 MySQL 是 GPLv2 加 FOSS 例外,MinIO 当前版本是 AGPLv3。二是当地法律:门店录音是否合法、需要何种告知,由你自行负责。
没有找到你要的答案?
联系我们
获取可部署方案与产品选型支持。